Cómo elaborar un plan de respuesta ante incidentes desde cero

por
Última actualización: Tiempo de lectura: 6 min

por
Última actualización: Puntos clave
Un ciberataque no avisa de su llegada. Una mañana, se activa una alerta, alguien abre un ticket y, para cuando se informa a la dirección, el daño ya se está extendiendo. Lo que diferencia a las empresas que logran contener una brecha de seguridad en cuestión de horas de aquellas que se ven atrapadas en el proceso de recuperación durante meses no es una tecnología mejor. Es la preparación. En concreto: si existía un plan antes de que ocurriera cualquier problema.
Un plan de respuesta ante incidentes (IRP) es un procedimiento documentado y probado para detectar, contener y recuperarse de los incidentes de seguridad. Suena burocrático. En la práctica, marca la diferencia entre una respuesta controlada y un caos organizado a las 2 de la madrugada.
No todas las alertas son incidentes. Un intento fallido de inicio de sesión es ruido. Que un ransomware cifre un servidor de archivos, no lo es. La distinción es importante porque determina quién interviene y con qué rapidez.
Categorías comunes que conviene definir antes de que ocurra nada:
Un correo electrónico de phishing en el que se ha hecho clic pero que no ha descargado nada es diferente de uno que ha instalado una baliza de Cobalt Strike. El plan debe contemplar ambos casos e informar al equipo de cuál es cuál, rápidamente.
Muchas organizaciones cuentan con un documento de respuesta ante incidentes. Son mucho menos las que tienen uno que alguien haya leído. Y aún menos las que lo hayan puesto a prueba en una situación que se parezca a un escenario real.
Los problemas habituales: el documento tiene tres años, incluye datos de contacto de personas que ya no trabajan en la empresa, parte de la base de que se utilizan herramientas que ya han sido sustituidas y nadie del equipo de respuesta real lo ha visto nunca. Resulta que hay una diferencia significativa entre tener un documento de política y disponer de un manual operativo. Uno sirve para satisfacer a los auditores. El otro es el que se utiliza cuando el sistema de producción se cae a las 3 de la madrugada y nadie sabe quién está autorizado a desconectar un servidor comprometido.
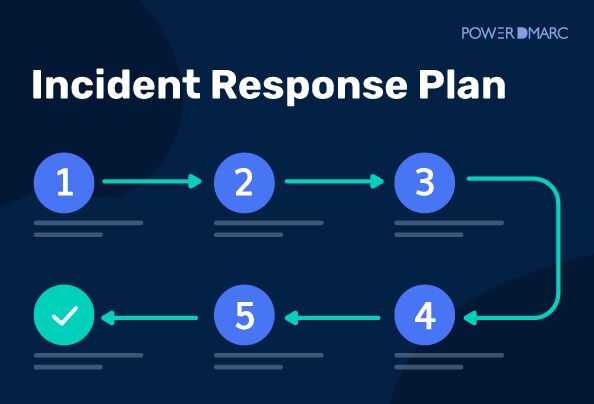
El marco NIST SP 800-61 divide la respuesta ante incidentes en seis fases. SANS utiliza una lógica similar, aunque con nombres distintos. En cualquier caso, la estructura se mantiene.

Todo lo que ocurre antes de un incidente. Aquí es donde se lleva a cabo el verdadero trabajo: definir qué es un incidente, formar y capacitar al equipo de respuesta, configurar la infraestructura de registro y alertas, y realizar simulacros. Un detalle que se suele pasar por alto constantemente: la autorización previa de las acciones. Durante un incidente en curso, esperar a la autorización legal para aislar un servidor supone una pérdida de tiempo que no te puedes permitir. Decide de antemano qué se puede hacer de inmediato y quién debe hacerlo, sin necesidad de escalar el asunto.
Ha ocurrido algo. La pregunta es: ¿qué, exactamente? Esta fase consiste en convertir las alertas en incidentes confirmados, correlacionar las señales entre las herramientas SIEM y EDR, determinar el alcance y elaborar una cronología. La rapidez en esta fase está directamente relacionada con la calidad de los registros configurados durante la preparación. Unos registros de mala calidad implican una identificación lenta. Una identificación lenta implica menos opciones.
La contención a corto plazo es rápida y contundente: aislar los equipos infectados, bloquear las direcciones IP de los atacantes y desactivar las cuentas comprometidas. La contención a largo plazo es más precisa: soluciones temporales, reconfiguración de sistemas y supervisión reforzada de comportamientos específicos. Una decisión que surge constantemente es: ¿desconectar inmediatamente o observar primero al atacante? La desconexión limita el daño. La supervisión revela el alcance total. Hay argumentos válidos a favor de ambas opciones. Esta decisión debe discutirse con antelación, no improvisarse bajo presión.
Elimina la amenaza por completo. Aplica los parches necesarios en los puntos vulnerables, elimina el malware y los mecanismos de persistencia, renueva las credenciales y restaura los sistemas afectados a partir de imágenes limpias. Saltarse este paso o hacerlo con prisas es lo que hace que las organizaciones vuelvan a verse afectadas por el mismo vector dos semanas después. Ocurre con más frecuencia de lo que se da a conocer.
Restablece los servicios por orden de prioridad. Comprueba que los sistemas estén limpios antes de volver a conectarlos. Vigila de cerca cualquier incidencia recurrente. Y cumple con las obligaciones de notificación: el RGPD establece un plazo de 72 horas para notificar a las autoridades de control tras una violación de datos personales. Ese plazo no se detiene por el hecho de que la recuperación aún esté en curso.
La fase que la mayoría de los equipos se saltan porque están agotados. Y precisamente por eso es importante. La revisión posterior al incidente debe realizarse en un plazo de dos semanas: qué ocurrió, qué funcionó, qué no funcionó, qué deficiencias se pusieron de manifiesto, qué cambios se van a introducir y en qué plazo. Documentadlo. Actualizad el plan. Y, a continuación, aplicad realmente los cambios; de lo contrario, no habrá sido más que una reunión.
El IRP describe qué hay que hacer. Las herramientas son las que permiten llevarlo a cabo con rapidez y bajo presión.
Las herramientas importan menos que el hecho de que la gente sepa cómo utilizarlas bajo presión. Una instancia de Splunk con 400 paneles de control y sin manuales de procedimientos no sirve de nada a nadie.
Dependiendo del sector y la zona geográfica, un IRP no es opcional, sino un requisito legal. Marcos normativos clave:
NIS2 y DORA son las normativas que están pillando desprevenidas a las organizaciones en estos momentos. Ambas elevan considerablemente el listón en cuanto a documentación, frecuencia de las pruebas y plazos de presentación de informes.
Algunas organizaciones desarrollan la capacidad de respuesta ante incidentes (IR) íntegramente de forma interna. La mayoría no cuenta con el personal ni la experiencia necesaria para hacerlo bien, sobre todo en lo que respecta a la simulación y las pruebas. He aquí una breve lista:
DXC Technology ofrece servicios integrales de desarrollo de programas de respuesta a incidentes (IR): diseño de planes, simulacros y servicios gestionados de detección y respuesta. Destaca especialmente en sectores regulados (energía, sanidad y servicios financieros), incluidas las soluciones de software para el sector energético, en las que el cumplimiento normativo se integra en el proyecto desde el principio.
Secureworks (Atlanta) ofrece servicios de contratación de respuesta a incidentes (IR) junto con su plataforma Taegis XDR. Su unidad «Counter Threat Unit» publica información continua sobre amenazas que se incorpora directamente a las actualizaciones de los manuales de actuación, lo cual resulta útil para los equipos que desean disponer de detección y respuesta en un único entorno.
WithSecure (Helsinki) adopta un enfoque consultivo para el desarrollo de programas de respuesta a incidentes (IR), en estrecha consonancia con los requisitos normativos europeos. Resulta más adecuado para organizaciones que están desarrollando su capacidad de respuesta a incidentes por primera vez que para aquellas que buscan un servicio gestionado en sentido estricto.
Trustwave (Chicago) combina servicios de seguridad gestionados con asesoramiento en respuesta a incidentes (IR) a través de SpiderLabs, un equipo rojo interno que ha elaborado algunos de los informes sobre amenazas del sector más detallados de la última década.
Orange Cyberdefense (Francia) se encarga de la coordinación transfronteriza de la respuesta a incidentes (IR) en múltiples jurisdicciones de la UE de forma simultánea. Resulta útil para las multinacionales que deben gestionar en paralelo las obligaciones derivadas de la Directiva NIS2 y del RGPD en distintos países.
Incluso los equipos mejor preparados cometen errores previsibles. Los más habituales son:
Y la más importante: considerar el plan como un proyecto puntual. Las amenazas cambian. Los sistemas cambian. La gente se va. Un IRP que no se actualiza de forma activa queda obsoleto antes de que sea necesario.
¿Cuánto tiempo se tarda en crear un IRP funcional partiendo de cero?
Se puede elaborar un plan básico en un plazo de cuatro a seis semanas. Un programa consolidado, con manuales de procedimientos, ejercicios probados e integraciones de herramientas, suele llevar, siendo realistas, entre tres y seis meses.
¿Con qué frecuencia se debe realizar la prueba?
Como mínimo, una vez al año. DORA y la mayoría de los marcos de trabajo empresariales recomiendan ahora realizar ejercicios de simulación teórica dos veces al año, con simulaciones completas al menos una vez. Tras cualquier incidente grave o cambio significativo en el sistema, se debe llevar a cabo una revisión inmediata.
¿Cuál es la diferencia entre un simulacro de mesa y un ejercicio de «equipo rojo»?
Una sesión teórica se basa en el debate; se analizan escenarios, pero no se tocan los sistemas. Una actividad de «equipo rojo» simula de forma activa las técnicas de los atacantes contra una infraestructura real. Ambas son valiosas y ponen a prueba aspectos diferentes.
¿Cuál es la primera medida que hay que tomar cuando se confirma un incidente?
Activa el equipo de respuesta, documenta la hora y los primeros indicadores, y pon en marcha las medidas de contención previamente autorizadas. No toques los sistemas infectados para limpiarlos antes de que se hayan conservado las pruebas forenses; esa información es la que revela el alcance total de lo ocurrido.


 ¿Qué es la etiqueta AVP de BIMI? Explicación de la preferencia de avatar